library(readr)
library(ggplot2)
library(tidyr)
library(dplyr)
library(coda)Partie 2 Construction du modèle hiérarchique bayésien version 2
1 PROJET STATISTIQUES COMPUTATIONNELLES
Algorithme HMC - Modèle Hiérarchique Poisson-Normal
Hyperparamètres : \(\sigma^2 \sim \text{Exp}(1)\), \(\mu \sim \mathcal{N}(0,4)\)
Reparamétrisation : \(\gamma = \log(\sigma^2)\), \(Z_i = \log(\lambda_i)\)
Il y a 5 fonction. Ce sont:
- fonction log_posterior_target : calculer la log posterior
- fonction gradient_target : calculer les gradients de log_postierior par les parametres \(Z_i\), \(\mu\), \(\gamma\)
- fonction leapfrog : calculer les steps pour algo HMC
- fonction hmc_sampler : algo HMC
- fonction run_hmc_chains_sequentially : pour faire des chaines en même temps
1.1 Importation
1.2 CHARGEMENT ET PRÉ-TRAITEMENT DES DONNÉES
# ------------------------------------------------------------------------------
# ------------------------------------------------------------------------------
# Bloc sécurisé : si le fichier n'est pas trouvé (pour tester le code),
# des données factices sont générées automatiquement.
if (file.exists("data/summary_tigre_moustique.csv")) {
    tigre <- read_csv("data/summary_tigre_moustique.csv", show_col_types = FALSE)
    unique_year <- unique(tigre$year)
    I <- length(unique_year)
    J_list <- numeric(I)
    y_list <- list()
    for (i in 1:I) {
        J_list[i] <- length(tigre[tigre$year == unique_year[i], ]$stateProvince)
        y_list[[i]] <- tigre[tigre$year == unique_year[i], ]$n_occurrences
    }
} else {
    cat("Fichier de données non trouvé. Utilisation de données simulées pour le test.\n")
    I <- 10
    J_list <- sample(5:15, I, replace = TRUE)
    y_list <- lapply(J_list, function(j) rpois(j, lambda = 5))
}

# Optimisation : On pré-calcule la somme des y pour chaque année (constant)
sum_y_list <- sapply(y_list, sum)
1.3 DÉFINITION DES FONCTIONS MATHÉMATIQUES
Définitions des fonctions : - Log à postériori - dérivées partielles - gradient
# Calcul de la Log-Postériori (L)
log_posterior_target <- function(theta, J_list, sum_y_list, I) {
    alphas <- theta[1:I]
    mu     <- theta[I + 1]
    gamma  <- theta[I + 2]

    # Terme 1: Vraisemblance de Poisson
    log_lik <- sum(-J_list * exp(alphas) + alphas * sum_y_list)

    # Terme 2: Loi a priori conditionnelle des alphas (Loi Normale)
    log_prior_alphas <- -0.5 * exp(-gamma) * sum((alphas - mu)^2) - (I/2) * gamma

    # Terme 3: Hyperpriors (mu ~ N(0, 4) et tau^2 ~ Exp(1) reparamétré en gamma)
    log_hyperpriors <- -(mu^2) / 8 - exp(gamma) + gamma

    return(log_lik + log_prior_alphas + log_hyperpriors)
}

# Calcul du Gradient de l'Énergie Hamiltonienne (nabla H)
# Rappel : H = -L, donc on implémente les formules dérivées trouvées précédemment
gradient_target <- function(theta, J_list, sum_y_list, I) {
    alphas <- theta[1:I]
    mu     <- theta[I + 1]
    gamma  <- theta[I + 2]

    grads <- numeric(I + 2)

    # Dérivées partielles par rapport aux alphas (Vectorisé)
    grads[1:I] <- J_list * exp(alphas) - sum_y_list + (alphas - mu) / exp(gamma)

    # Dérivée partielle par rapport à mu
    grads[I + 1] <- (mu / 4) - sum(alphas - mu) / exp(gamma)

    # Dérivée partielle par rapport à gamma
    grads[I + 2] <- (I / 2 - 1) - 0.5 * exp(-gamma) * sum((alphas - mu)^2) + exp(gamma)

    return(grads)
}
1.4 Implémentation des algorithmes
# Algorithme Leapfrog (Saute-Mouton)
leapfrog <- function(q, p, step_size, L_steps, J_list, sum_y_list, I) {
    # Demi-pas initial pour l'impulsion (Attention : signe MOINS car on minimise H)
    p <- p - 0.5 * step_size * gradient_target(q, J_list, sum_y_list, I)

    for (l in 1:L_steps) {
        # Pas complet pour la position
        q <- q + step_size * p

        # Pas complet pour l'impulsion (sauf au dernier tour)
        if (l < L_steps) {
            p <- p - step_size * gradient_target(q, J_list, sum_y_list, I)
        }
    }

    # Demi-pas final pour l'impulsion
    p <- p - 0.5 * step_size * gradient_target(q, J_list, sum_y_list, I)

    # Inversion de l'impulsion (pour symétrie de la chaîne de Markov)
    p <- -p

    return(list(q = q, p = p))
}

# Fonction principale HMC
hmc_sampler <- function(init_theta, iterations, step_size, L_steps, J_list, sum_y_list, I) {
    d <- length(init_theta)
    samples <- matrix(NA, nrow = iterations, ncol = d)
    samples[1, ] <- init_theta

    acceptances <- 0

    for (t in 2:iterations) {
        current_q <- samples[t - 1, ]

        # 1. Tirage de l'impulsion aléatoire
        current_p <- rnorm(d, mean = 0, sd = 1)

        # 2. Simulation de la trajectoire
        traj <- leapfrog(current_q, current_p, step_size, L_steps, J_list, sum_y_list, I)
        proposed_q <- traj$q
        proposed_p <- traj$p

        # 3. Évaluation de l'Énergie Hamiltonienne (H = -L + K)
        current_U <- -log_posterior_target(current_q, J_list, sum_y_list, I)
        current_K <- sum(current_p^2) / 2
        current_H <- current_U + current_K

        proposed_U <- -log_posterior_target(proposed_q, J_list, sum_y_list, I)
        proposed_K <- sum(proposed_p^2) / 2
        proposed_H <- proposed_U + proposed_K

        # === CRASH TEST DIAGNOSTIC (intégré et silencieux si tout va bien) ===
        if (is.na(proposed_H) || proposed_H == Inf) {
            cat(sprintf("\n[ALERTE] Itération %d: Trajectoire divergente.\n", t))
            cat(sprintf("Gamma: %.3f | Max Alpha: %.3f\n", proposed_q[I+2], max(proposed_q[1:I])))
        }

        # 4. Étape de Metropolis
        # Probabilité d'acceptation : min(1, exp(current_H - proposed_H))
        log_acceptance <- current_H - proposed_H

        # Protection contre les NA/NaN
        if (is.na(log_acceptance)) log_acceptance <- -Inf

        if (log(runif(1)) < log_acceptance) {
            samples[t, ] <- proposed_q
            acceptances <- acceptances + 1
        } else {
            samples[t, ] <- current_q
        }

        # Affichage de la progression tous les 10%
        if (t %% max(1, floor(iterations / 10)) == 0) {
            cat(sprintf("Progression : %d / %d itérations...\n", t, iterations))
        }
    }

    cat(sprintf("\nTaux d'acceptation final : %.1f %%\n", (acceptances / (iterations - 1)) * 100))
    return(samples)
}
1.5 EXÉCUTION DU MODÈLE (Wrapper multi-chaînes)
run_hmc_chains_sequentially <- function(n_chains, iterations, step_size, L_steps) {
    all_chains <- list()
    for (chain in 1:n_chains) {
        cat(sprintf("\n--- DÉMARRAGE DE LA CHAÎNE %d ---\n", chain))

        # Initialisation sur-dispersée intelligente
        init_mu <- rnorm(1, mean = 0, sd = 2)
        # On tire gamma directement dans N(0,1) pour bien explorer
        init_gamma <- rnorm(1, mean = 0, sd = 1)
        init_alphas <- rnorm(I, mean = init_mu, sd = sqrt(exp(init_gamma)))

        theta_0 <- c(init_alphas, init_mu, init_gamma)

        # Lancement
        samples <- hmc_sampler(
            init_theta = theta_0,
            iterations = iterations,
            step_size = step_size,
            L_steps = L_steps,
            J_list = J_list,
            sum_y_list = sum_y_list,
            I = I
        )

        # POST-TRAITEMENT : On remet tau^2 et lambda à l'endroit pour l'utilisateur
        # Colonnes 1 à I : alphas -> lambdas (exponentielle)
        samples[, 1:I] <- exp(samples[, 1:I])
        # Colonne I+2 : gamma -> tau^2 (exponentielle)
        samples[, I+2] <- exp(samples[, I+2])

        # Optionnel: renommer les colonnes pour que ce soit propre
        colnames(samples) <- c(paste0("lambda_", 1:I), "mu", "tau2")

        all_chains[[chain]] <- samples
    }
    return(all_chains)
}
# --- PARAMÈTRES ET LANCEMENT DU TEST ---
# On utilise un step_size prudent (0.01 ou 0.05) pour éviter l'explosion de Poisson
# L=15 à 20 permet de compenser le petit pas de temps
set.seed(42) # Pour la reproductibilité
resultats_finaux <- run_hmc_chains_sequentially(
n_chains = 2,
iterations = 1000,
step_size = 0.01,
L_steps = 15
)
--- DÉMARRAGE DE LA CHAÎNE 1 ---
Progression : 100 / 1000 itérations...
Progression : 200 / 1000 itérations...
Progression : 300 / 1000 itérations...
Progression : 400 / 1000 itérations...
Progression : 500 / 1000 itérations...
Progression : 600 / 1000 itérations...
Progression : 700 / 1000 itérations...
Progression : 800 / 1000 itérations...
Progression : 900 / 1000 itérations...
Progression : 1000 / 1000 itérations...

Taux d'acceptation final : 99.4 %

--- DÉMARRAGE DE LA CHAÎNE 2 ---
Progression : 100 / 1000 itérations...
Progression : 200 / 1000 itérations...
Progression : 300 / 1000 itérations...
Progression : 400 / 1000 itérations...
Progression : 500 / 1000 itérations...
Progression : 600 / 1000 itérations...
Progression : 700 / 1000 itérations...
Progression : 800 / 1000 itérations...
Progression : 900 / 1000 itérations...
Progression : 1000 / 1000 itérations...

Taux d'acceptation final : 99.7 %
# Aperçu des 5 premières lignes de la chaîne 1 (pour mu et tau2)
cat("\nAperçu des paramètres hyper-globaux (Chaîne 1) :\n")
Aperçu des paramètres hyper-globaux (Chaîne 1) :print(head(resultats_finaux[[1]][, c("mu", "tau2")])) mu tau2
[1,] 2.741917 0.5685317
[2,] 2.737898 0.4349729
[3,] 2.434297 0.4679140
[4,] 2.419968 0.5123930
[5,] 2.419968 0.5123930
[6,] 2.179766 0.53953512 Résultats
2.1 Histogramme des distributions a postériori
# 1. Définir le burn-in (généralement la moitié des itérations)
n_iter <- nrow(resultats_finaux[[2]])
burn_in <- floor(n_iter / 2)

# 2. Extraire et combiner les chaînes (sans le burn-in)
# On parcourt la liste des chaînes, on coupe le début, et on transforme en data.frame
samples_list <- lapply(1:length(resultats_finaux), function(i) {
    df <- as.data.frame(resultats_finaux[[i]][(burn_in + 1):n_iter, ])
    return(df)
})

# On fusionne toutes les chaînes en un seul grand tableau
samples_df <- bind_rows(samples_list)

# 3. Transformer les données du format "Large" au format "Long"
# Cela va créer deux colonnes : "Parametre" (le nom de la variable) et "Valeur"
samples_long <- samples_df %>%
    pivot_longer(cols = everything(), names_to = "Parametre", values_to = "Valeur")

# Optionnel : Transformer "Parametre" en facteur pour fixer l'ordre d'affichage
# (Sinon ggplot va les trier par ordre alphabétique)
samples_long$Parametre <- factor(samples_long$Parametre, levels = colnames(samples_df))

# 4. Créer le graphique avec ggplot2 et facet_wrap
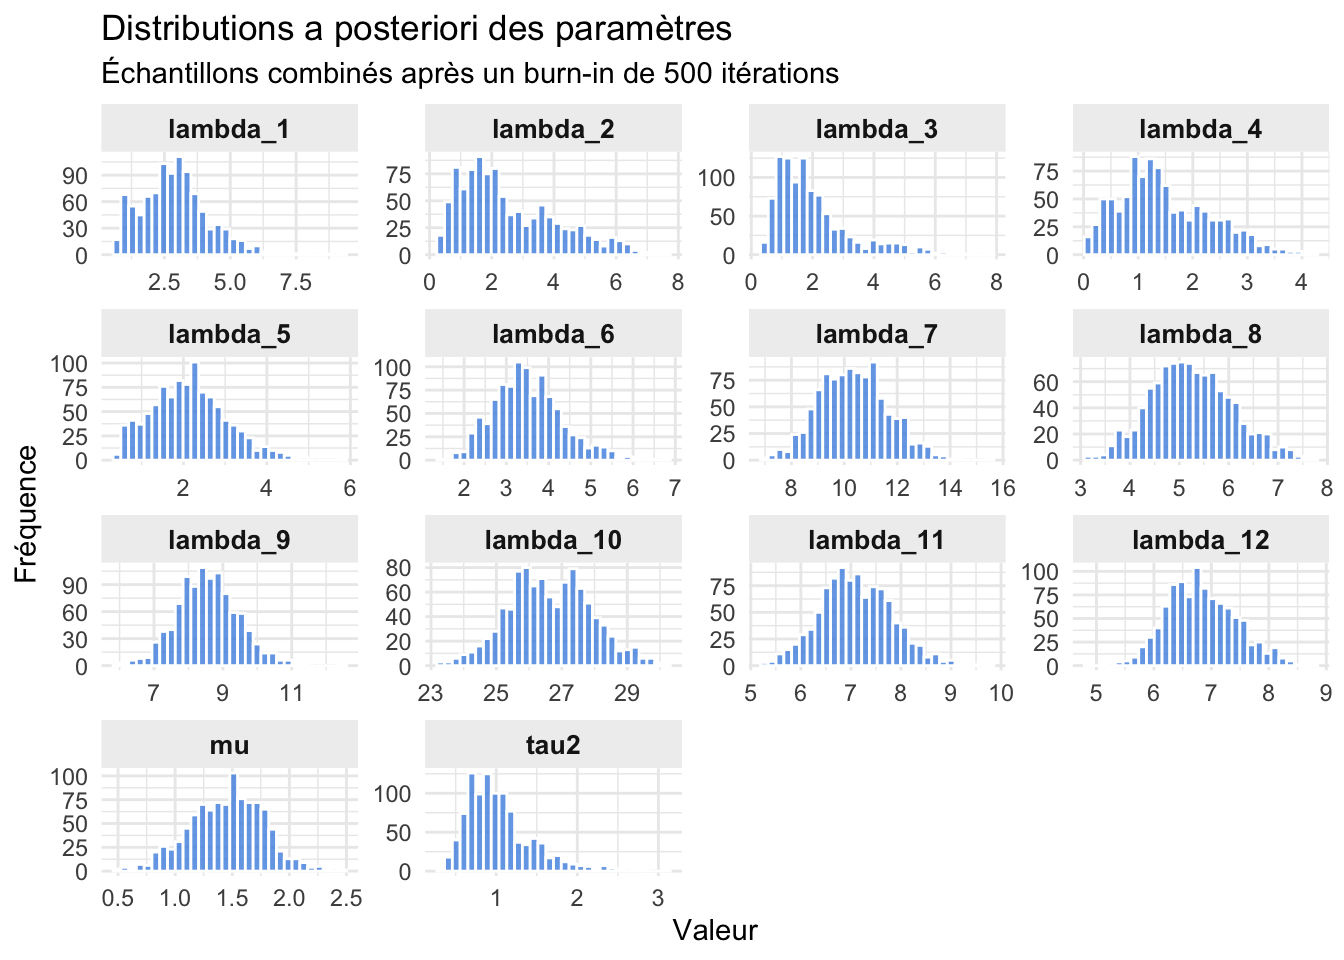
ggplot(samples_long, aes(x = Valeur)) +
    geom_histogram(bins = 30, fill = "#4A90E2", color = "white", alpha = 0.8) +
    facet_wrap(~ Parametre, scales = "free") + # scales="free" donne un axe X et Y propre à chaque variable
    theme_minimal() +
    theme(
        strip.background = element_rect(fill = "#EFEFEF", color = NA),
        strip.text = element_text(face = "bold", size = 10)
    ) +
    labs(
        title = "Distributions a posteriori des paramètres",
        subtitle = paste("Échantillons combinés après un burn-in de", burn_in, "itérations"),
        x = "Valeur",
        y = "Fréquence"
    )
2.2 Anlayse des performances
2.2.1 DIAGNOSTICS DE CONVERGENCE ET PERFORMANCES (Question 7)
# 5.1 Conversion des résultats au format de l'objet 'mcmc.list' de coda
# On utilise la variable 'burn_in' que tu as défini précédemment.
mcmc_chains <- lapply(resultats_finaux, function(chain) {
    # On coupe le burn-in et on transforme la matrice en objet 'mcmc'
    mcmc(chain[(burn_in + 1):nrow(chain), ])
})
mcmc_list_obj <- mcmc.list(mcmc_chains)

# Pour éviter de surcharger les graphiques, on se concentre sur les hyperparamètres
# et un effet aléatoire au hasard (lambda_1)
params_to_check <- c("mu","tau2","lambda_1")

# ---------------------------------------------------------
# A. LA CONVERGENCE : TRACEPLOTS VISUELS
# ---------------------------------------------------------
# On crée proprement un dataframe dédié pour le traceplot avec les infos de chaîne
trace_list <- lapply(1:length(resultats_finaux), function(i) {
    # On récupère la chaîne sans le burn-in
    df <- as.data.frame(resultats_finaux[[i]][(burn_in + 1):n_iter, ])
    # On ajoute la chaîne et l'itération avant de pivoter
    df$Chain <- i
    df$Iteration <- 1:nrow(df)
    return(df)
})

# On fusionne, on pivote au format long, et on filtre
trace_df <- bind_rows(trace_list) %>%
    pivot_longer(cols = -c(Chain, Iteration), names_to = "Parametre", values_to = "Valeur") %>%
    filter(Parametre %in% params_to_check)
trace_plot <- ggplot(trace_df, aes(x = Iteration, y = Valeur, color = as.factor(Chain))) +
    geom_line(alpha = 0.6, linewidth = 0.3) +
    facet_wrap(~ Parametre, scales = "free_y", ncol = 1) +
    scale_color_manual(values = c("#E66100", "#5D3A9B")) +
    theme_minimal() +
    labs(
        title = "Traceplots (Diagnostic de Convergence)",
        color = "Chaîne",
        x = "Itération (post burn-in)",
        y = "Valeur du paramètre"
    )

# Affichage du Traceplot (à inclure dans le rapport)
print(trace_plot)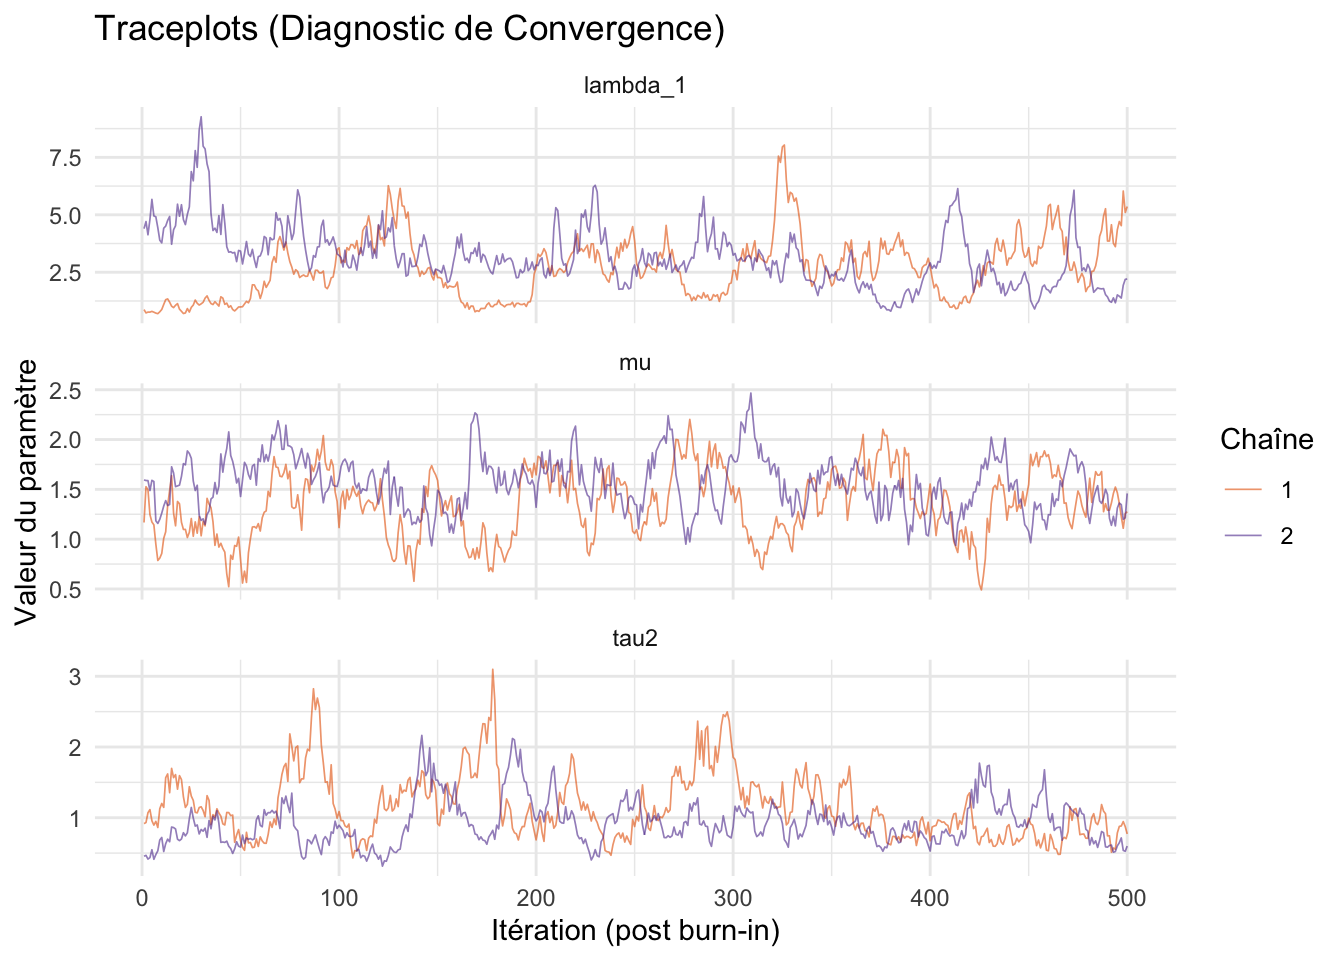
2.2.2 LES PERFORMANCES : AUTOCORRÉLATION (ACF)
# On ouvre une nouvelle fenêtre graphique pour les tracés d'autocorrélation de base
# (On trace seulement pour la Chaîne 1 pour simplifier)
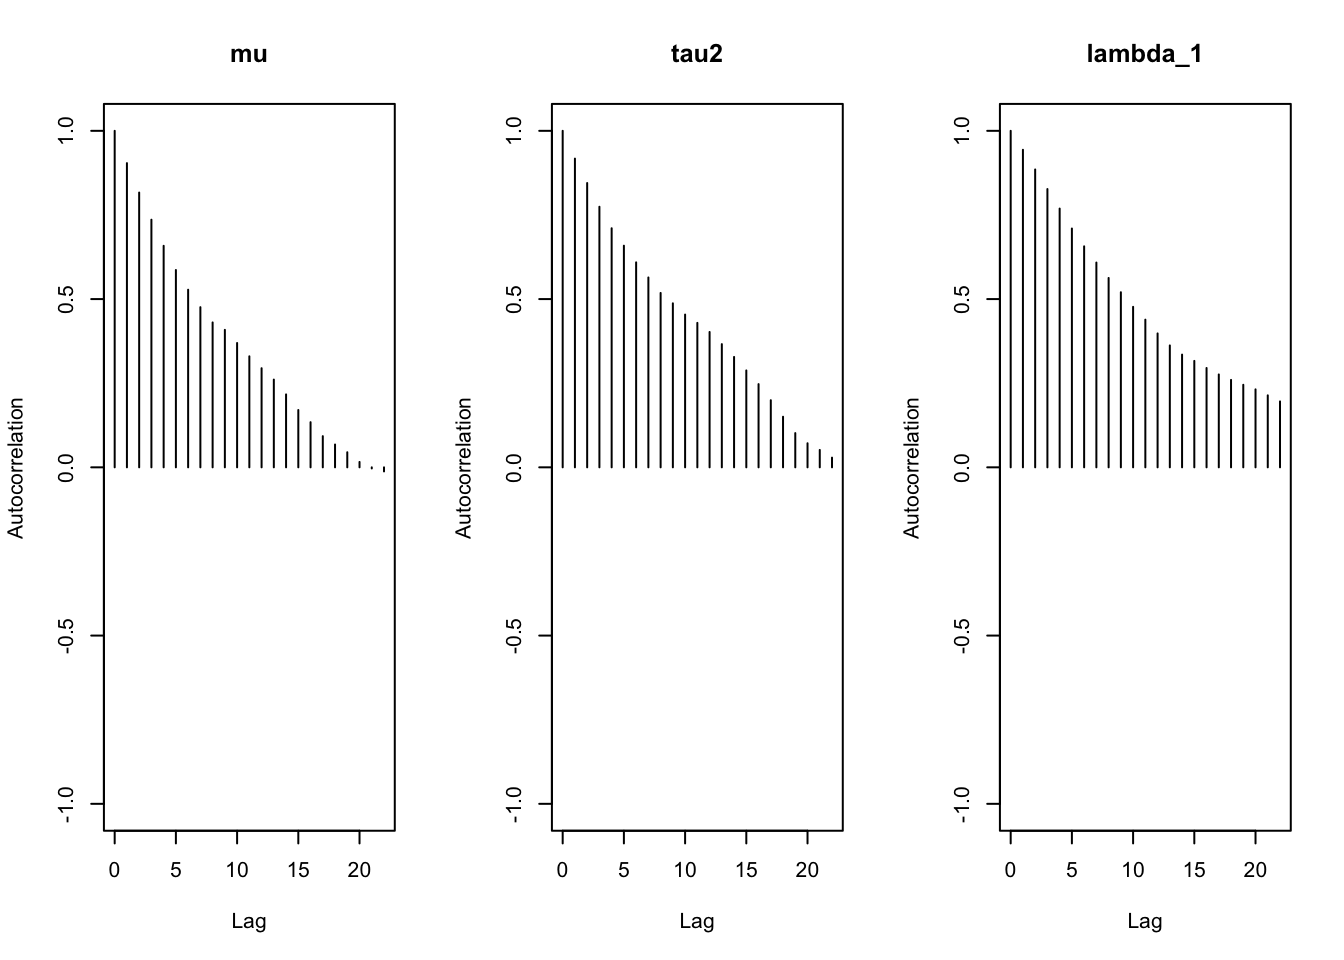
par(mfrow = c(1, length(params_to_check)))
autocorr.plot(mcmc_chains[[1]][, params_to_check],
              ask = FALSE,
              auto.layout = FALSE
              )
par(mfrow = c(1, 1)) # Réinitialisation des paramètres graphiques2.2.3 ANALYSE DES RÉSULTATS (Question 8)
# 1. Calcul des statistiques résumées (Estimateurs et Intervalles)
# On utilise le tableau 'samples_long' généré dans ton bloc d'histogrammes
resume_stats <- samples_long %>%
    group_by(Parametre) %>%
    summarise(
        Moyenne_Post = mean(Valeur),
        Mediane_Post = median(Valeur),
        Borne_Inf_95 = quantile(Valeur, 0.025),
        Borne_Sup_95 = quantile(Valeur, 0.975)
    )

# Affichage du tableau (tu pourras exporter ceci dans ton rapport)
print(as.data.frame(resume_stats), digits = 3)
Parametre Moyenne_Post Mediane_Post Borne_Inf_95 Borne_Sup_95
1 lambda_1 2.93 2.854 0.901 5.98
2 lambda_2 2.56 2.112 0.512 6.18
3 lambda_3 2.04 1.705 0.580 5.56
4 lambda_4 1.49 1.332 0.183 3.36
5 lambda_5 2.14 2.113 0.623 4.07
6 lambda_6 3.53 3.442 2.140 5.41
7 lambda_7 10.36 10.322 8.023 13.00
8 lambda_8 5.26 5.200 3.744 6.97
9 lambda_9 8.55 8.530 6.921 10.37
10 lambda_10 26.64 26.588 24.248 29.15
11 lambda_11 7.11 7.075 5.731 8.63
12 lambda_12 6.83 6.784 5.755 8.11
13 mu 1.45 1.478 0.804 2.05
14 tau2 1.04 0.953 0.476 2.09# 2. Visualisation de la variabilité inter-année (Forest Plot des lambda)
# On filtre pour ne garder que les paramètres lambda
lambda_stats <- resume_stats %>%
filter(grepl("lambda", Parametre)) %>%
# Pour un affichage propre, on extrait le numéro de l'année
mutate(Annee_Index = as.numeric(gsub("lambda_", "", Parametre))) %>%
arrange(Annee_Index) # Tri temporel
# Création du Forest Plot
forest_plot <- ggplot(lambda_stats, aes(x = reorder(Parametre, Annee_Index), y = Moyenne_Post)) +
geom_point(size = 3, color = "#2C3E50") +
geom_errorbar(aes(ymin = Borne_Inf_95, ymax = Borne_Sup_95), width = 0.2, color = "#E74C3C", linewidth = 1) +
coord_flip() + # Inverse les axes pour faciliter la lecture
theme_minimal() +
labs(
title = "Variabilité Inter-Année des Occurrences (Paramètres lambda)",
subtitle = "Moyenne a posteriori et Intervalles de crédibilité à 95%",
x = "Effet aléatoire (Année)",
y = "Nombre moyen d'occurrences estimé (lambda)"
) +
theme(
axis.text.y = element_text(face = "bold"),
plot.title = element_text(face = "bold", size = 14)
)
# Affichage du graphique
print(forest_plot)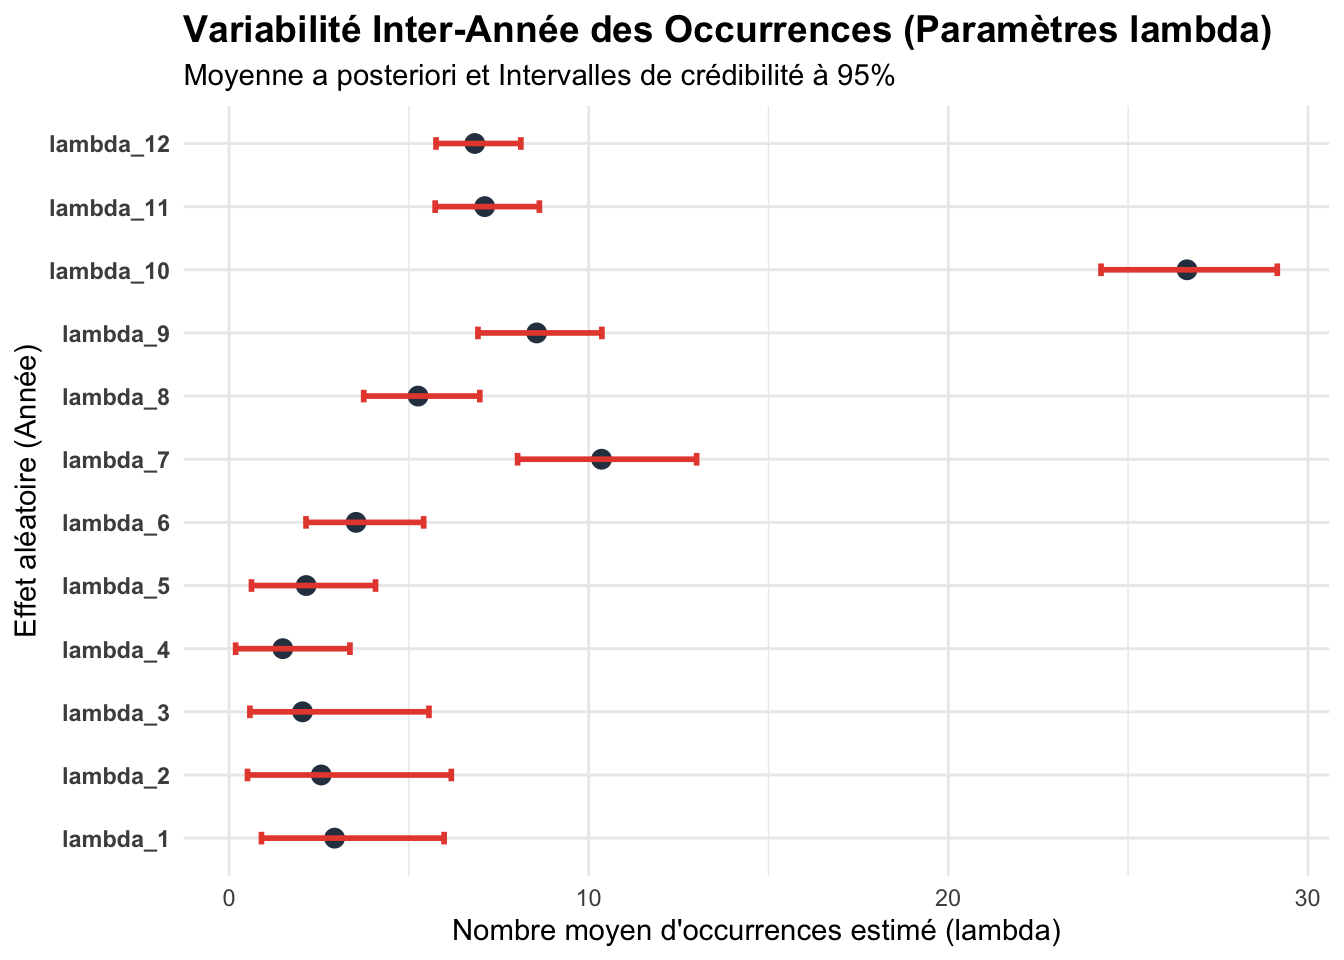
# Commentaire automatique sur tau^2 pour aider la rédaction
tau2_est <- resume_stats %>% filter(Parametre == "tau2")
cat(sprintf("\n[Analyse] La variance inter-année (tau^2) est estimée en moyenne à %.3f [95%% CI: %.3f - %.3f].\n",
            tau2_est$Moyenne_Post, tau2_est$Borne_Inf_95, tau2_est$Borne_Sup_95))
[Analyse] La variance inter-année (tau^2) est estimée en moyenne à 1.040 [95% CI: 0.476 - 2.092].2.3 QUALITÉ PRÉDICTIVE DU MODÈLE (Question 9)
# 1. Préparation des vraies données
# On regroupe toutes les vraies observations (issues de y_list) en un seul vecteur
y_obs <- unlist(y_list)

# On choisit deux statistiques de test pertinentes pour des données de comptage :
# - La proportion de zéros (les sites sans moustiques)
# - La valeur maximale (les invasions extrêmes)
stat_obs_zero <- mean(y_obs == 0)
stat_obs_max  <- max(y_obs)

# 2. Préparation des simulations
# Pour garder un temps de calcul rapide, on va tirer au hasard 1000 échantillons
# de ta distribution a posteriori (largement suffisant pour le diagnostic)
n_samples_ppc <- min(1000, nrow(samples_df))
set.seed(42) # Reproductibilité
indices_ppc <- sample(1:nrow(samples_df), n_samples_ppc)

rep_stat_zero <- numeric(n_samples_ppc)
rep_stat_max  <- numeric(n_samples_ppc)

cat("Génération des données prédictives a posteriori en cours...\n")
Génération des données prédictives a posteriori en cours...# 3. Boucle de simulation
for (t in 1:n_samples_ppc) {
idx <- indices_ppc[t]
y_rep_t <- numeric(0)
# Pour chaque année i, on simule de nouvelles données avec le lambda_i estimé
for (i in 1:I) {
# Extraction du lambda estimé à cette itération MCMC
lambda_i_t <- samples_df[idx, paste0("lambda_", i)]
# Simulation de J_i (nombre de sites) observations selon la loi de Poisson
y_rep_t <- c(y_rep_t, rpois(J_list[i], lambda = lambda_i_t))
}
# On calcule les statistiques sur ce faux jeu de données
rep_stat_zero[t] <- mean(y_rep_t == 0)
rep_stat_max[t] <- max(y_rep_t)
}
# 4. Calcul des "p-values bayésiennes"
# (Probabilité que la statistique simulée soit supérieure ou égale à la vraie)
# Un bon modèle a une p-value bayésienne proche de 0.5 (la vérité est au milieu)
# Si c'est proche de 0 ou 1, le modèle échoue à prédire cet aspect.
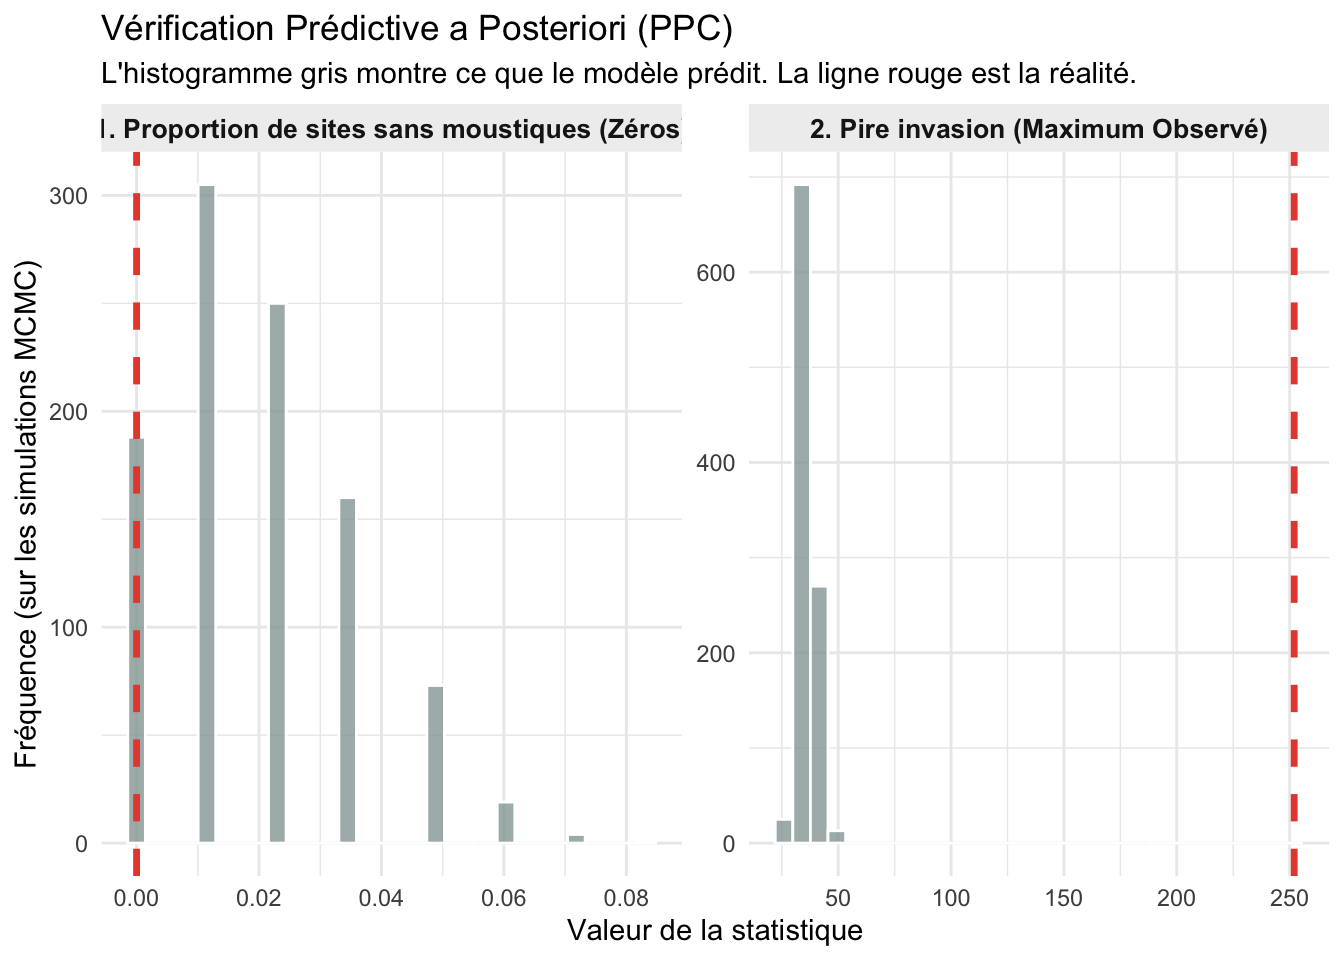
p_val_zero <- mean(rep_stat_zero >= stat_obs_zero)
p_val_max <- mean(rep_stat_max >= stat_obs_max)
cat(sprintf("P-value bayésienne (Proportion de zéros) : %.3f\n", p_val_zero))P-value bayésienne (Proportion de zéros) : 1.000cat(sprintf("P-value bayésienne (Maximum observé) : %.3f\n", p_val_max))P-value bayésienne (Maximum observé) : 0.000# 5. Visualisation graphique (à mettre dans le rapport)
ppc_long <- data.frame(
Valeur = c(rep_stat_zero, rep_stat_max),
Statistique = rep(c("1. Proportion de sites sans moustiques (Zéros)",
"2. Pire invasion (Maximum Observé)"),
each = n_samples_ppc)
)
obs_lines <- data.frame(
Valeur_obs = c(stat_obs_zero, stat_obs_max),
Statistique = c("1. Proportion de sites sans moustiques (Zéros)",
"2. Pire invasion (Maximum Observé)")
)
ppc_plot <- ggplot(ppc_long, aes(x = Valeur)) +
geom_histogram(fill = "#95A5A6", color = "white", bins = 30, alpha = 0.8) +
geom_vline(data = obs_lines, aes(xintercept = Valeur_obs),
color = "#E74C3C", linewidth = 1.2, linetype = "dashed") +
facet_wrap(~ Statistique, scales = "free") +
theme_minimal() +
labs(
title = "Vérification Prédictive a Posteriori (PPC)",
subtitle = "L'histogramme gris montre ce que le modèle prédit. La ligne rouge est la réalité.",
x = "Valeur de la statistique",
y = "Fréquence (sur les simulations MCMC)"
) +
theme(
strip.background = element_rect(fill = "#EFEFEF", color = NA),
strip.text = element_text(face = "bold", size = 10)
)
print(ppc_plot)