Partie 3 : Modèle Extension

Author

NGUYEN Duc Hoang Viet

1 Modele Extension

On pourra considérer l’extension suivante pour expliquer une partie de la variabilité entre années :

\[ \begin{aligned} y_{ij} \mid \lambda_{ij} &\sim \text{Poisson}(\lambda_{ij}) \\ \log \lambda_{ij} &= \alpha_j + \beta x_{ij} \\ \alpha_j \mid \mu, \sigma^2 &\sim \mathcal{N}(\mu, \sigma^2) \end{aligned} \]

où \(x_{ij}\) est une covariable environnementale et \(\beta\) un paramètre supplémentaire à estimer.

Hyperparamètres : \(\sigma^2 \sim \text{Exp}(1)\), \(\mu \sim \mathcal{N}(0,4)\), \(\beta \sim \mathcal{N}(0,10)\)

Reparamétrisation : \(\gamma = \log(\sigma^2)\), \(Z_i = \log(\lambda_i)\)

Il y a 5 fonction. Ce sont:

  • fonction log_posterior_ext : calculer la log posterior
  • fonction les gradients : calculer les gradients de -log_postierior par les parametres \(Z_i\), \(\mu\), \(\gamma\)
  • fonction leapfrog_ext : calculer les steps pour algo HMC
  • fonction HMC_step_ext : algo HMC
  • fonction run_chain_ext : pour faire des chaines en même temps
  • fonction get_temp_site : Récupérer et calculer les températures moyennes annuelles

Dans cette partie, nous avons exploité les coordonnées des sites afin de récupérer les données de température via la NASA en utilisant le package “nasapower”. Malheureusement, ce package ne fournit plus les températures annuelles directes, mais seulement les données mensuelles. Par conséquent, nous les avons récupérées et calculé “à la main” les moyennes annuelles.(T2M)

# ------------------------------------------------------------------------------
#                   CHARGEMENT ET PRÉ-TRAITEMENT DES DONNÉES
# ------------------------------------------------------------------------------
library(rgbif)
library(dplyr)
library(sf)
library(maps)

tigre_moustique_data <- occ_search(
  scientificName = "Aedes albopictus",
  country = "FR",
  limit = 2210,
)$data

# ------------------------------------------------------------------------------
#                   RESUME DES DONNÉES
summary_table <- tigre_moustique_data %>%
  filter(!is.na(year), !is.na(stateProvince)) %>%  
  group_by(year, stateProvince) %>%                 
  summarise(n_occurrences = n(), .groups = "drop") 

# Extraction des coordonnées moyennes (centroïdes) de chaque province à partir des données brutes
sites_coords <- tigre_moustique_data %>%
  filter(!is.na(stateProvince), !is.na(decimalLongitude), !is.na(decimalLatitude)) %>%
  group_by(stateProvince) %>%
  summarise(
    X = mean(decimalLongitude, na.rm = TRUE),
    Y = mean(decimalLatitude, na.rm = TRUE),
    .groups = "drop"
  )

# Vérification du nombre de provinces (doit être égal à 23)
print(nrow(sites_coords))
[1] 26

2 Récuperer les données pour la covariable environnementale Xij

get_temp_site <- function(lon, lat) {
  # 1. Récupération des données depuis l'API NASA POWER
  data <- get_power(
    community = "ag",lonlat = c(lon, lat),pars = "T2M", 
    dates = c("2014-01-01", "2025-12-31"),
    temporal_api = "monthly"
  )
  
  # 2. Traitement pour calculer la moyenne annuelle selon la structure de la table retournée
  if ("T2M" %in% colnames(data)) {
    # CAS 1 : Format "Long" (la colonne T2M est déjà présente)
    data_yearly <- data %>%
      group_by(YEAR) %>%
      summarise(
        T2M = mean(T2M, na.rm = TRUE),
        .groups = "drop"
      )
  } else {
    # CAS 2 : Format "Wide" (les mois sont dans des colonnes séparées : JAN, FEB...)
    month_cols <- intersect(c("JAN", "FEB", "MAR", "APR", "MAY", "JUN", 
                              "JUL", "AUG", "SEP", "OCT", "NOV", "DEC"), 
                            colnames(data))
    
    data_yearly <- data %>%
      mutate(T2M = rowMeans(select(., all_of(month_cols)), na.rm = TRUE)) %>%
      select(YEAR, T2M)
  }
  
  # 3. Réaffectation des coordonnées pour conserver l'information géographique lors de la fusion
  data_yearly$LON <- lon
  data_yearly$LAT <- lat
  
  return(data_yearly)
}
library(nasapower)
library(sf)
library(dplyr)

# Initialisation d'une liste pour stocker les données de température
all_temps <- list()

for(i in 1:nrow(sites_coords)) {
  # Message de suivi dans la console
  cat("Récupération des températures pour le département :",
    sites_coords$stateProvince[i],
    " (", i, "/23)...\n")
  flush.console()
  
  # Appel de la fonction get_temp_site pour obtenir les données (vérification T2M incluse)
  temp_data <- get_temp_site(sites_coords$X[i], sites_coords$Y[i])
  
  # Ajout du nom du département pour faciliter la fusion ultérieure des données (Join)
  temp_data$stateProvince <- sites_coords$stateProvince[i]
  
  # Stockage dans la liste
  all_temps[[i]] <- temp_data
  
  # Pause pour respecter les limites de l'API NASA POWER
  Sys.sleep(0.5) 
}
Récupération des températures pour le département : Alsace  ( 1 /23)...
Récupération des températures pour le département : Aquitaine  ( 2 /23)...
Récupération des températures pour le département : Ardèche (07)  ( 3 /23)...
Récupération des températures pour le département : Auvergne  ( 4 /23)...
Récupération des températures pour le département : Bourgogne  ( 5 /23)...
Récupération des températures pour le département : Bretagne  ( 6 /23)...
Récupération des températures pour le département : Centre  ( 7 /23)...
Récupération des températures pour le département : Corrèze (19)  ( 8 /23)...
Récupération des températures pour le département : Corse  ( 9 /23)...
Récupération des températures pour le département : Côte-d'Or (21)  ( 10 /23)...
Récupération des températures pour le département : Dordogne (24)  ( 11 /23)...
Récupération des températures pour le département : Isère (38)  ( 12 /23)...
Récupération des températures pour le département : Languedoc-Roussillon  ( 13 /23)...
Récupération des températures pour le département : Limousin  ( 14 /23)...
Récupération des températures pour le département : Lot (46)  ( 15 /23)...
Récupération des températures pour le département : Midi-Pyrénées  ( 16 /23)...
Récupération des températures pour le département : Occitanie  ( 17 /23)...
Récupération des températures pour le département : Pays de la Loire  ( 18 /23)...
Récupération des températures pour le département : Poitou-Charentes  ( 19 /23)...
Récupération des températures pour le département : Provence-Alpes-Côte d'Azur  ( 20 /23)...
Récupération des températures pour le département : Pyrénées-Atlantiques (64)  ( 21 /23)...
Récupération des températures pour le département : Rhône (69)  ( 22 /23)...
Récupération des températures pour le département : Rhône-Alpes  ( 23 /23)...
Récupération des températures pour le département : Savoie (73)  ( 24 /23)...
Récupération des températures pour le département : Vaucluse (84)  ( 25 /23)...
Récupération des températures pour le département : Île-de-France  ( 26 /23)...
# Fusion des résultats dans un tableau (data.frame) final
df_temp_final <- bind_rows(all_temps)
df_temp_final
────────────────────────────────────────────────────────────────────────────────
────────────────────────────────────────────────────────────────────────────────
────────────────────────────────────────────────────────────────────────────────
# A tibble: 312 × 5
    YEAR   T2M   LON   LAT stateProvince
   <dbl> <dbl> <dbl> <dbl> <chr>        
 1  2014 11.0   7.58  48.4 Alsace       
 2  2015 10.7   7.58  48.4 Alsace       
 3  2016 10.1   7.58  48.4 Alsace       
 4  2017 10.4   7.58  48.4 Alsace       
 5  2018 11.4   7.58  48.4 Alsace       
 6  2019 10.9   7.58  48.4 Alsace       
 7  2020 11.3   7.58  48.4 Alsace       
 8  2021  9.70  7.58  48.4 Alsace       
 9  2022 12.0   7.58  48.4 Alsace       
10  2023 12.1   7.58  48.4 Alsace       
# ℹ 302 more rows
# Fusion des données de température avec la table récapitulative (summary_table)
final_data_for_model <- summary_table %>%
  left_join(df_temp_final, by = c("year" = "YEAR", "stateProvince" = "stateProvince")) %>%
  filter(!is.na(T2M))
# Standardisation de la température (X_ij) pour le modèle de Poisson (centrage et réduction)
final_data_for_model$X_ij <- as.numeric(scale(final_data_for_model$T2M))

# 1. Tri des données pour garantir que l'ordre des Z_j corresponde à site_idx
final_data_for_model <- final_data_for_model %>% 
  arrange(stateProvince, year)

# 2. Vecteur de la variable dépendante (Nombre d'occurrences de moustiques)
Y_ext <- final_data_for_model$n_occurrences 

# 3. Vecteur de la variable indépendante (Température standardisée X_ij)
X_ext <- final_data_for_model$X_ij

# 4. Vecteur d'indice des sites (Crucial pour la correspondance avec Z_j)
# Génère un vecteur de type : 1, 1, 1... (12 fois), 2, 2, 2... (12 fois), etc.
site_idx <- as.numeric(factor(final_data_for_model$stateProvince))

# Affichage du nombre total d'observations prêtes pour le modèle
cat("Nombre final d'observations introduites dans le modèle :", length(Y_ext), "\n")
Nombre final d'observations introduites dans le modèle : 81 

3 La fonction de log-posteriori

log_posterior_ext <- function(Z, beta, Y, X, site_idx, mu, gamma) { 
  sigma2 <- exp(gamma)
  
  # --- Terme 1 : Log-Vraisemblance de Poisson ---
  # log_lambda = Z_j + beta * X_ij
  # Z[site_idx] permet d'affecter le bon Z_j à chaque ligne d'observation
  log_lambda <- Z[site_idx] + beta * X
  
  # Formule de la log-vraisemblance : sum(y * log_lambda - exp(log_lambda))
  # (On omet log(y!) car c'est une constante)
  log_vrais <- sum(Y * log_lambda - exp(log_lambda))
  
  # --- Terme 2 : Loi a priori conditionnelle des Zj (Loi Normale) ---
  # Z_j ~ N(mu, sigma2) pour les 23 sites
  log_prior_Z <- sum(dnorm(Z, mean = mu, sd = sqrt(sigma2), log = TRUE))
  
  # --- Terme 3 : Loi a priori de beta ---
  # beta ~ N(0, 10) -> sd = sqrt(10)
  log_prior_beta <- dnorm(beta, mean = 0, sd = sqrt(10), log = TRUE)
  
  # --- Terme 4 : Lois a priori de μ et σ2 ---
  # Prior pour la moyenne globale mu
  log_prior_mu <- dnorm(mu, mean = 0, sd = 2, log = TRUE)
  
  # Prior pour sigma2 (Loi Exponentielle)
  # Note : dexp(sigma2...) + gamma inclut l'ajustement du Jacobien 
  # pour le changement de variable gamma = log(sigma2)
  log_prior_sigma2 <- dexp(sigma2, rate = 1, log = TRUE) + gamma 
  
  # --- Somme Totale (Log-Posteriori) ---
  res <- log_vrais + log_prior_Z + log_prior_beta + log_prior_mu + log_prior_sigma2
  
  # Vérification de la stabilité numérique
  if (is.na(res) || is.infinite(res)) return(-1e20) 
  
  return(res)
}

4 Les fonctions de gradients

# ------------------------------------------------------------------------------
#       Gradient de l'Énergie Potentielle U(theta) = -log_posterior
# ------------------------------------------------------------------------------
# Calcul du gradient de l'énergie (nabla U) pour l'algorithme HMC.
# Rappel : U = -log(pi(theta|y)), nous implémentons ici les dérivées 
# partielles analytiques obtenues précédemment.
# ------------------------------------------------------------------------------

grad_Z_ext <- function(Z, beta, Y, X, site_idx, mu, gamma) {
  sigma2 <- exp(gamma)
  
  # Calcul de lambda pour l'ensemble des 276 observations
  log_lambda <- Z[site_idx] + beta * X
  lambda <- exp(log_lambda)
  
  # Erreur (Espérance - Observation)
  error <- lambda - Y
  
  # Agrégation des erreurs par site (somme de lambda_ij - Y_ij pour chaque site j)
  # On utilise tapply pour réduire les 276 lignes aux 23 sites
  grad_lik_Z <- as.numeric(tapply(error, site_idx, sum))
  
  # Dérivée de la loi a priori (Prior) N(mu, sigma2)
  grad_prior_Z <- (Z - mu) / sigma2
  
  return(grad_lik_Z + grad_prior_Z)
}

grad_beta <- function(Z, beta, Y, X, site_idx) {
  log_lambda <- Z[site_idx] + beta * X
  lambda <- exp(log_lambda)
  
  # Dérivée de la log-vraisemblance par rapport à beta : sum(X_ij * (lambda_ij - Y_ij))
  grad_lik_beta <- sum(X * (lambda - Y))
  
  # Dérivée de la loi a priori beta ~ N(0, 10) : beta / 10
  grad_prior_beta <- beta / 10
  
  return(grad_lik_beta + grad_prior_beta)
}

grad_mu_ext <- function(Z, mu, gamma) {
  sigma2 <- exp(gamma)
  # Dérivée issue du prior de Z + dérivée du prior de mu lui-même (mu ~ N(0, 4))
  return(sum(mu - Z) / sigma2 + mu / 4)
}

grad_gamma_ext <- function(Z, mu, gamma) {
  sigma2 <- exp(gamma)
  I <- length(Z) # I = 23
  # Dérivée par rapport à gamma = log(sigma2), incluant la correction du Jacobien
  return(-sum((Z - mu)^2) / (2 * sigma2) + I / 2 + sigma2 - 1)
}

5 Algorithme Hamilton Monte Carlo avec methode leapfrog

leapfrog_ext <- function(Z, beta, mu, gamma, P_Z, P_beta, P_mu, P_gamma, Y, X, site_idx, eps, L, f_grad_Z, f_grad_beta, f_grad_mu, f_grad_gamma) {
  
  # Premier demi-pas pour les impulsions (Momentum half-step)
  P_Z     <- P_Z     - 0.5 * eps * f_grad_Z(Z, beta, Y, X, site_idx, mu, gamma)
  P_beta  <- P_beta  - 0.5 * eps * f_grad_beta(Z, beta, Y, X, site_idx)
  P_mu    <- P_mu    - 0.5 * eps * f_grad_mu(Z, mu, gamma)
  P_gamma <- P_gamma - 0.5 * eps * f_grad_gamma(Z, mu, gamma)
  
  for (l in 1:L) {
    # Mise à jour des positions (Position update)
    Z     <- Z     + eps * P_Z
    beta  <- beta  + eps * P_beta
    mu    <- mu    + eps * P_mu    
    gamma <- gamma + eps * P_gamma 
    
    if (l < L) {
      # Mise à jour complète des impulsions (sauf pour le dernier pas)
      P_Z     <- P_Z     - eps * f_grad_Z(Z, beta, Y, X, site_idx, mu, gamma)
      P_beta  <- P_beta  - eps * f_grad_beta(Z, beta, Y, X, site_idx)
      P_mu    <- P_mu    - eps * f_grad_mu(Z, mu, gamma)
      P_gamma <- P_gamma - eps * f_grad_gamma(Z, mu, gamma)
    }
  }
  
  # Dernier demi-pas pour les impulsions (Final momentum half-step)
  P_Z     <- P_Z     - 0.5 * eps * f_grad_Z(Z, beta, Y, X, site_idx, mu, gamma)
  P_beta  <- P_beta  - 0.5 * eps * f_grad_beta(Z, beta, Y, X, site_idx)
  P_mu    <- P_mu    - 0.5 * eps * f_grad_mu(Z, mu, gamma)
  P_gamma <- P_gamma - 0.5 * eps * f_grad_gamma(Z, mu, gamma)
  
  return(list(Z = Z, beta = beta, mu = mu, gamma = gamma, P_Z = P_Z, P_beta = P_beta, P_mu = P_mu, P_gamma = P_gamma))
}

HMC_step_MC_ext <- function(Z, beta, mu, gamma, Y, X, site_idx, eps, L, lp_func, f_grad_Z, f_grad_beta, f_grad_mu, f_grad_gamma) {
  
  # 1. Initialisation des impulsions aleatoire
  P_Z_init     <- rnorm(length(Z))
  P_beta_init  <- rnorm(1)
  P_mu_init    <- rnorm(1)
  P_gamma_init <- rnorm(1)
  
  # 2. Calcul de l'énergie initiale (Hamiltonien initial)
  init_U <- -lp_func(Z, beta, Y, X, site_idx, mu, gamma)
  init_K <- sum(P_Z_init^2)/2 + P_beta_init^2/2 + P_mu_init^2/2 + P_gamma_init^2/2
  
  # 3. Leapfrog
  res <- leapfrog_ext(Z, beta, mu, gamma, P_Z_init, P_beta_init, P_mu_init, P_gamma_init, Y, X, site_idx, eps, L, f_grad_Z, f_grad_beta, f_grad_mu, f_grad_gamma)
  
  # 4. Calcul de l'énergie finale (Hamiltonien final)
  final_U <- -lp_func(res$Z, res$beta, Y, X, site_idx, res$mu, res$gamma)
  final_K <- sum(res$P_Z^2)/2 + res$P_beta^2/2 + res$P_mu^2/2 + res$P_gamma^2/2
  
  # 5. Accept/Reject
  if (log(runif(1)) < (init_U + init_K - final_U - final_K)) {
    return(list(Z = res$Z, beta = res$beta, mu = res$mu, gamma = res$gamma, accepted = TRUE))
  } else {
    return(list(Z = Z, beta = beta, mu = mu, gamma = gamma, accepted = FALSE))
  }
}

run_chain_ext <- function(id, n_iter, Y, X, site_idx, eps, L) {
  # 1. Initialisation Empirique (Pour favoriser la convergence)
 
  # Calcul de la moyenne par site pour mồi (moyenner sur les années)
  # Correction : on utilise Y (l'argument de la fonction) et non Y_ext (variable globale)
  Y_mean_site <- as.numeric(tapply(Y, site_idx, mean))
  
  # Initialisation de Z (log-moyenne par site)
  curr_Z      <- log(Y_mean_site + 0.1)
  
  # Initialisation de beta (effet neutre au départ)
  curr_beta   <- 0
  
  # Initialisation des hyperparamètres (mu et gamma)
  curr_mu     <- mean(curr_Z)
  curr_gamma  <- log(var(curr_Z))
  
  # 2. Sauvegarde des échantillons (Traces)
  beta_trace  <- numeric(n_iter)
  mu_trace    <- numeric(n_iter)
  sigma_trace <- numeric(n_iter)
  Z_trace     <- matrix(0, n_iter, 23) 
  accepted_count_ext <- 0
  
  # 3. Boucle MCMC (Algorithme HMC)
  for (k in 1:n_iter) {
    res <- HMC_step_MC_ext(curr_Z, curr_beta, curr_mu, curr_gamma, Y, X, site_idx, eps, L, 
                           lp_func = log_posterior_ext, 
                           f_grad_Z = grad_Z_ext, 
                           f_grad_beta = grad_beta,
                           f_grad_mu = grad_mu_ext, 
                           f_grad_gamma = grad_gamma_ext)
    
    # Mise à jour des valeurs actuelles
    curr_Z     <- res$Z
    curr_beta  <- res$beta
    curr_mu    <- res$mu
    curr_gamma <- res$gamma
    
    if (res$accepted) {
      accepted_count_ext <- accepted_count_ext + 1
    }
    
    # Enregistrement dans les traces
    beta_trace[k]  <- curr_beta
    mu_trace[k]    <- curr_mu
    sigma_trace[k] <- sqrt(exp(curr_gamma))
    Z_trace[k, ]   <- curr_Z
    
    # Affichage de la progression et du taux d'acceptation
    if (k %% max(1, floor(n_iter / 10)) == 0) {
      current_acc_rate <- (accepted_count_ext / k) * 100 
      cat(sprintf("  Chaîne %d | Progression : %d / %d (%d%%) | Taux d'acc. : %.1f%%\n", 
                  id, k, n_iter, round(k/n_iter*100), current_acc_rate))
    }
  }
  
  final_acc_rate_ext <- (accepted_count_ext / n_iter) 
  cat(sprintf("=> Chaîne %d terminée avec succès. Taux d'acceptation final : %.2f%%\n", 
              id, final_acc_rate_ext * 100))
  
  return(list(mu = mu_trace, sigma = sigma_trace, beta = beta_trace, Z = Z_trace, acc_rate = final_acc_rate_ext))
}
6 Main

# ------------------------------------------------------------------------------
#           Main : Lancement de la Simulation MCMC (Version Extension)
# ------------------------------------------------------------------------------

# Paramètres de simulation
n_chains <- 1 ; n_iter <- 5000; eps <- 0.01; L<- 100 

# Liste pour stocker les résultats de chaque chaîne
all_results_ext <- list()

set.seed(42) 

for (i in 1:n_chains) {
  cat(sprintf("\n--- Démarrage de la Chaîne %d ---", i))
  cat(sprintf("\nConfiguration : n_iter = %d, eps = %.4f, L = %d\n", n_iter, eps, L))
  
  start_time <- Sys.time()
  
  # Appel de la fonction de simulation
  # Note : Y_ext et X_ext doivent être définis au préalable
  all_results_ext[[i]] <- run_chain_ext(id = i, n_iter = n_iter, Y = Y_ext, 
    X = X_ext, site_idx = site_idx, eps  = eps,  L = L)
  
  end_time <- Sys.time()
  duration <- as.numeric(end_time - start_time, units="mins")
  
  cat(sprintf("=> Chaîne %d terminée en %.2f minutes.\n", i, duration))
}

--- Démarrage de la Chaîne 1 ---
Configuration : n_iter = 5000, eps = 0.0100, L = 100
  Chaîne 1 | Progression : 500 / 5000 (10%) | Taux d'acc. : 98.2%
  Chaîne 1 | Progression : 1000 / 5000 (20%) | Taux d'acc. : 98.3%
  Chaîne 1 | Progression : 1500 / 5000 (30%) | Taux d'acc. : 98.5%
  Chaîne 1 | Progression : 2000 / 5000 (40%) | Taux d'acc. : 98.8%
  Chaîne 1 | Progression : 2500 / 5000 (50%) | Taux d'acc. : 98.7%
  Chaîne 1 | Progression : 3000 / 5000 (60%) | Taux d'acc. : 98.7%
  Chaîne 1 | Progression : 3500 / 5000 (70%) | Taux d'acc. : 98.8%
  Chaîne 1 | Progression : 4000 / 5000 (80%) | Taux d'acc. : 98.9%
  Chaîne 1 | Progression : 4500 / 5000 (90%) | Taux d'acc. : 98.9%
  Chaîne 1 | Progression : 5000 / 5000 (100%) | Taux d'acc. : 98.9%
=> Chaîne 1 terminée avec succès. Taux d'acceptation final : 98.92%
=> Chaîne 1 terminée en 1.54 minutes.

7 Les Résultats

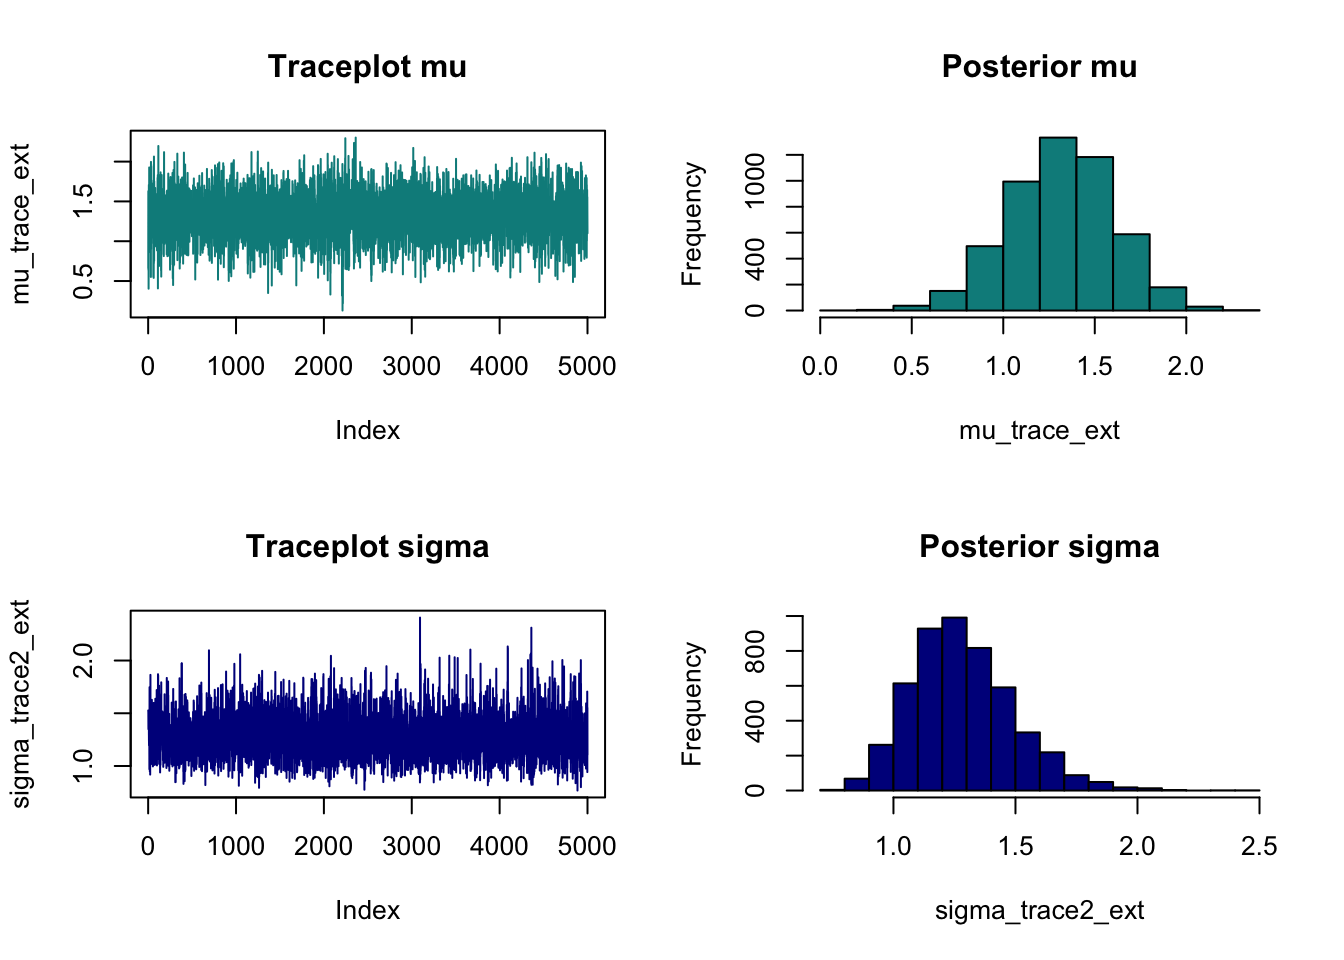
par(mfrow=c(2,2))

# Visualisation des paramètres globaux (Mu et Sigma) - Chaîne 1

# --- ANALYSE DE MU (Moyenne globale des log-intensités) ---
mu_trace_ext <- all_results_ext[[1]]$mu
plot(mu_trace_ext, type="l" ,col="darkcyan", main="Traceplot mu")
hist(mu_trace_ext, col="darkcyan",main="Posterior mu")
# --- ANALYSE DE SIGMA (Écart-type de la variabilité interannuelle) ---
sigma_trace2_ext <- all_results_ext[[1]]$sigma
plot(sigma_trace2_ext, type="l",col="darkblue", main="Traceplot sigma")
hist(sigma_trace2_ext,col="darkblue", main="Posterior sigma")

# Export les resultats de chaine 1
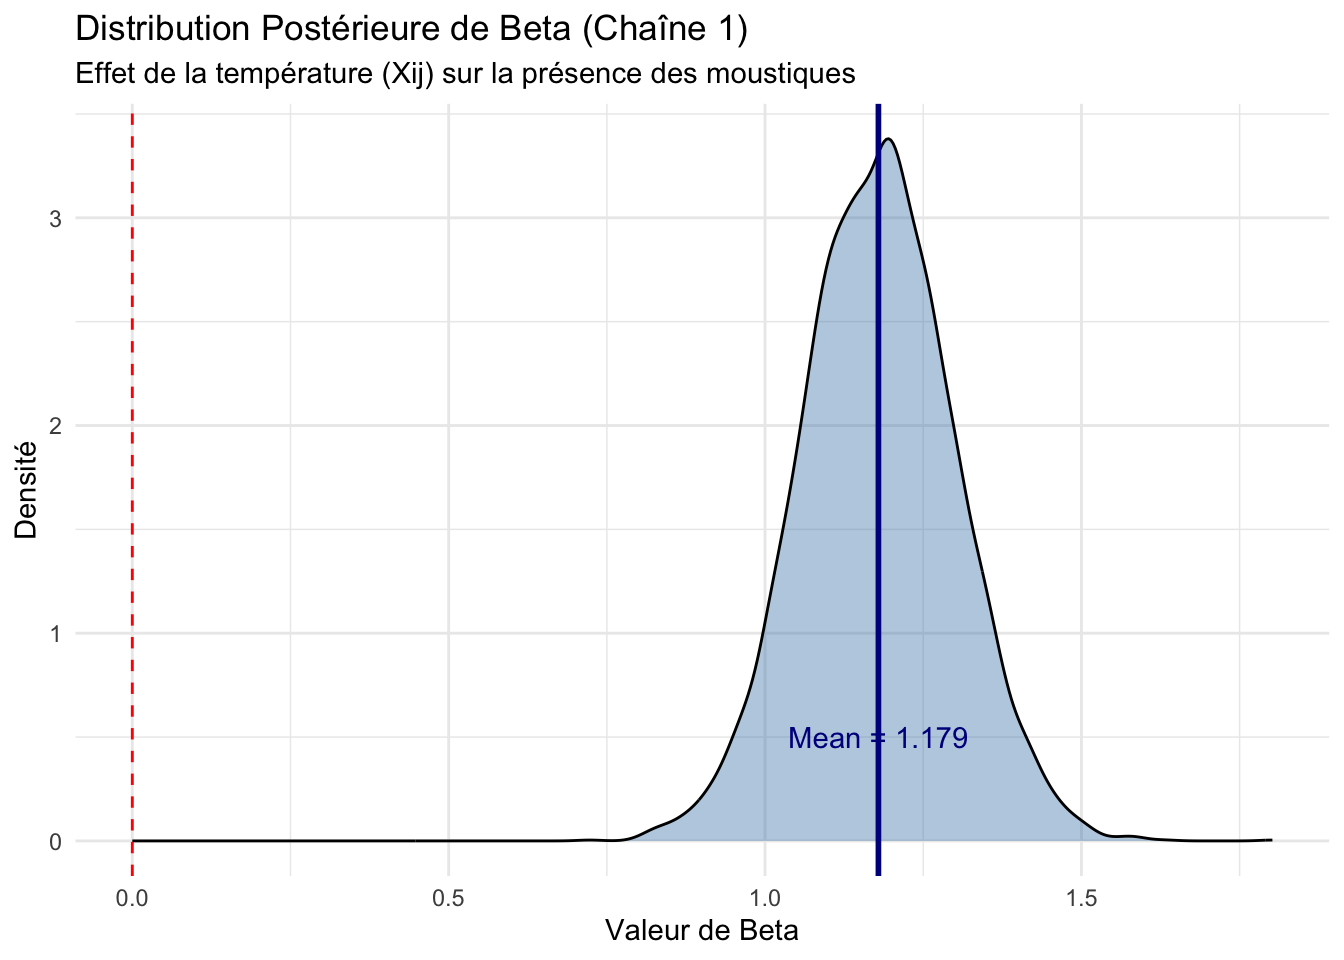
beta_samples <- all_results_ext[[1]]$beta

# 2. Calcule le moyen, mean, sd, Ic
beta_mean <- mean(beta_samples)
beta_sd   <- sd(beta_samples)
beta_CI   <- quantile(beta_samples, probs = c(0.025, 0.975)) # Intervalle de Confiance 95%
beta_median <- median(beta_samples)

# 3. Met dans un tableau
res_beta <- data.frame(
  Paramètre = "Beta (Température Xij)",
  Estimate = round(beta_mean, 4),
  Std.Error = round(beta_sd, 4),
  Lower_CI_95 = round(beta_CI[1], 4),
  Upper_CI_95 = round(beta_CI[2], 4),
  Median = round(beta_median, 4)
)

print("--- Résumé des estimations pour la covariable environnementale ---")
[1] "--- Résumé des estimations pour la covariable environnementale ---"
print(res_beta)
                  Paramètre Estimate Std.Error Lower_CI_95 Upper_CI_95 Median
2.5% Beta (Température Xij)   1.1792    0.1186      0.9475      1.4135 1.1808
library(ggplot2)

ggplot(data.frame(beta = beta_samples), aes(x = beta)) +
  geom_density(fill = "steelblue", alpha = 0.4) +
  geom_vline(aes(xintercept = beta_mean), color = "darkblue", linetype = "solid", size = 1) +
  geom_vline(aes(xintercept = 0), color = "red", linetype = "dashed") +
  annotate("text", x = beta_mean, y = 0.5, label = paste("Mean =", round(beta_mean, 3)), color = "darkblue") +
  labs(
    title = "Distribution Postérieure de Beta (Chaîne 1)",
    subtitle = "Effet de la température (Xij) sur la présence des moustiques",
    x = "Valeur de Beta",
    y = "Densité"
  ) +
  theme_minimal()

# sigma du modèle précédent (calculé dans la section précédente)
sigma_old <- 1.042131

# sigma du nouveau modèle (Extension avec covariable)
sigma_new <- mean(all_results_ext[[1]]$sigma)

# Affichage des résultats
cat(sprintf("Moyen de σ^2  sans l'effet de la température : %.3f\n", sigma_old))
Moyen de σ^2  sans l'effet de la température : 1.042
cat(sprintf("Moyen de σ^2  après inclusion de la température (Xij) : %.3f\n", sigma_new))
Moyen de σ^2  après inclusion de la température (Xij) : 1.282
# mu du modèle précédent (calculé dans la section précédente)
mu_old <- 1.391148

# mu du nouveau modèle (Extension avec covariable)
mu_new <- mean(all_results_ext[[1]]$mu)

# Affichage des résultats pour la moyenne globale
cat(sprintf("Moyenne de μ sans l'effet de la température : %.3f\n", mu_old))
Moyenne de μ sans l'effet de la température : 1.391
cat(sprintf("Moyenne de μ après inclusion de la température (Xij) : %.3f\n", mu_new))
Moyenne de μ après inclusion de la température (Xij) : 1.318
# Transformation des paramètres et construction de la matrice finale
# ------------------------------------------------------------------------------

Z_trace2 <- all_results_ext[[1]]$Z
Z_samples2 <- Z_trace2
λ_samples2 <- exp(Z_samples2)
mu_trace <- all_results_ext[[1]]$mu
sigma_trace <-all_results_ext[[1]]$sigma
beta_samples <- all_results_ext[[1]]$beta

# Regroupement des Lambda (12 colonnes), de Mu et de Sigma
samples_matrix2 <- cbind(λ_samples2, mu_trace, sigma_trace, beta_samples )
n_l <- ncol(λ_samples2)
colnames(samples_matrix2) <- c(paste0("λ", 1:n_l), "μ", "σ^2","beta")

head(round(samples_matrix2,5))
           λ1      λ2      λ3      λ4       λ5      λ6      λ7      λ8       λ9
[1,] 74.88563 3.16900 3.50835 4.20870  8.98682 1.89121 5.17949 0.05845 10.33760
[2,] 15.26221 5.08174 1.54361 5.24816 23.59863 2.69814 1.30187 0.73913  4.22238
[3,] 38.91880 3.96782 3.32689 3.77703  2.43428 0.27097 2.27540 0.19692  4.82875
[4,] 12.18143 5.18863 1.59177 2.16319  8.64828 0.52341 1.73257 1.00864  1.81104
[5,] 32.68156 3.89131 2.98807 3.21621  4.43841 1.75437 1.31386 0.31526  0.65229
[6,] 24.43369 4.95616 5.19238 5.74721  6.62224 1.49036 1.21864 0.55061  0.24845
         λ10      λ11     λ12     λ13     λ14      λ15     λ16     λ17     λ18
[1,] 1.37767 57.96315 1.41985 0.55505 3.55163  8.38235 4.46050 3.70789 5.09887
[2,] 0.51677 20.75240 4.47465 0.64109 4.43463 22.71961 3.19751 4.08376 7.99408
[3,] 1.77542 33.83168 2.42314 2.87705 4.58951 12.97319 3.56798 3.12906 6.12467
[4,] 1.15483 19.46529 4.77682 0.82227 6.42224 29.43794 2.87839 3.87426 9.99942
[5,] 1.00469 35.65180 2.53007 0.42973 4.59827 13.60516 2.36777 3.80848 6.78714
[6,] 2.78673 20.97653 3.57296 0.12514 6.43162 19.04972 3.20751 3.97999 7.00024
         λ19     λ20       λ21     λ22     λ23       μ     σ^2    beta
[1,] 0.25213 6.32886 131.09630 0.48194 0.90915 0.66106 1.52654 1.80178
[2,] 0.35530 0.29021  51.73369 1.81410 0.36002 1.62864 1.50915 0.87451
[3,] 0.84782 1.56387 100.27522 1.83686 0.94554 0.63909 1.35464 1.45303
[4,] 0.35551 0.90035  45.93490 2.87742 0.55091 1.44022 1.34747 0.72296
[5,] 0.92762 1.29658  71.57517 0.61237 0.32553 0.40400 1.43578 1.30301
[6,] 1.02787 1.31250  66.61629 0.43415 0.27181 1.21667 1.44926 1.10941
# Eliminer 1000 premiere ligne 
clean_samples2 <- samples_matrix2[1001:5000, ]

# 1.Posterior Mean)
post_mean2 <- colMeans(clean_samples2)

# 2. Interval de confiances 95% (95% Credible Interval)
post_ci2 <- apply(clean_samples2, 2, quantile, probs = c(0.025, 0.975))

# 3. Met dans un tableau 
results2 <- data.frame(
  Parameter = colnames(clean_samples2),
  Estimate = post_mean2,
  CI_lower = post_ci2[1, ],
  CI_upper = post_ci2[2, ]
)

print(results2)
     Parameter   Estimate   CI_lower   CI_upper
λ1          λ1 22.0645063 11.8226281 36.5463341
λ2          λ2  4.4022871  2.9921061  5.8810290
λ3          λ3  3.0022567  0.6348678  7.4810667
λ4          λ4  3.6206198  0.9351517  8.4655021
λ5          λ5  8.6205740  2.6860083 18.6237733
λ6          λ6  2.3970295  0.5453292  5.8754554
λ7          λ7  2.2959641  0.3427753  6.2908089
λ8          λ8  0.5171408  0.2811205  0.8632798
λ9          λ9  4.6873612  0.5753484 14.4561231
λ10        λ10  1.3070453  0.3055167  3.0755880
λ11        λ11 28.4561212 18.7105084 40.2195614
λ12        λ12  3.0611016  2.1752501  4.1480213
λ13        λ13  1.5185603  0.2624010  4.0791046
λ14        λ14  4.8204353  3.6021260  6.1633433
λ15        λ15 16.5592430 12.0309840 22.2858253
λ16        λ16  3.3112283  1.4306806  5.9725733
λ17        λ17  4.1169221  2.4734965  6.1608319
λ18        λ18  6.6624865  5.0784151  8.4796493
λ19        λ19  2.0029491  0.3130565  5.4285604
λ20        λ20  5.5427976  0.6716229 17.9755206
λ21        λ21 71.9029785 53.3203935 95.0303405
λ22        λ22  5.0597401  0.5741208 16.0387529
λ23        λ23  0.7882489  0.1534326  2.0293324
μ            μ  1.3191695  0.7456590  1.8661494
σ^2        σ^2  1.2814582  0.9302094  1.7564364
beta      beta  1.1797705  0.9475796  1.4088491

8 Conclusion

Ce projet a permis de développer un modèle bayésien hiérarchique pour étudier la dynamique d’invasion du moustique tigre sur 12 ans. Les résultats montrent une progression importante de l’espèce au fil du temps, avec une forte variabilité entre les années et entre les régions. L’utilisation de l’algorithme HMC a assuré une bonne convergence du modèle et des estimations fiables.

L’analyse met également en évidence l’importance des facteurs environnementaux. La température exerce un effet positif significatif sur l’abondance du moustique, confirmant son rôle majeur dans le processus d’invasion. L’ajout de cette covariable améliore la capacité explicative du modèle et permet de mieux prendre en compte les différences observées entre les territoires.

Enfin, malgré certaines limites liées aux événements extrêmes et à l’hétérogénéité spatiale, le modèle fournit un cadre robuste pour comprendre et anticiper l’expansion du moustique tigre. Il constitue ainsi un outil pertinent pour la surveillance écologique et l’aide à la décision en matière de santé publique.

9 Références

  1. Neal, R. M. MCMC using Hamiltonian Dynamics. University of Toronto, Canada. https://arxiv.org/pdf/1206.1901

  2. Walker, E., Soubeyrand, S. Hamiltonian Monte Carlo in Practice. Institut National de la Recherche Agronomique (INRA), Avignon, France. https://biosp.mathnum.inrae.fr/sites/default/files/2021-03/RR2016_49.pdf

  3. Chen, Y. C. Lecture 9: Hamiltonian Monte Carlo (Leapfrog). University of Washington. https://faculty.washington.edu/yenchic/19A_stat535/Lec9_HMC.pdf

  4. IBM Documentation. Statistiques bayésiennes (SPSS Statistics). IBM Docs. https://www.ibm.com/docs/fr/spss-statistics/cd?topic=ctas-bayesian-statistics

  5. IRD (Institut de Recherche pour le Développement). Changement climatique : le moustique tigre gagne du terrain en Europe. https://lemag.ird.fr/fr/changement-climatique-le-moustique-tigre-gagne-du-terrain-en-europe

  6. ANSES (Agence nationale de sécurité sanitaire). Le moustique tigre (Aedes albopictus). https://www.anses.fr/fr/content/le-moustique-tigre

V

MADE BY NGUYEN DUC HOANG VIET

PROJET MODÈLE HIÉRARCHIQUE BAYÉSIEN

© 2026 NGUYEN Duc Hoang Viet & Tchanang Yvan Michel — Tous droits réservés.
Université de Lille — Projet Modèle hiérarchique bayésien pour l’écologie
Toute reproduction, diffusion ou utilisation sans autorisation est interdite.